

Custos e limites
O custo é calculado por tarifa configurada
Section titled “O custo é calculado por tarifa configurada”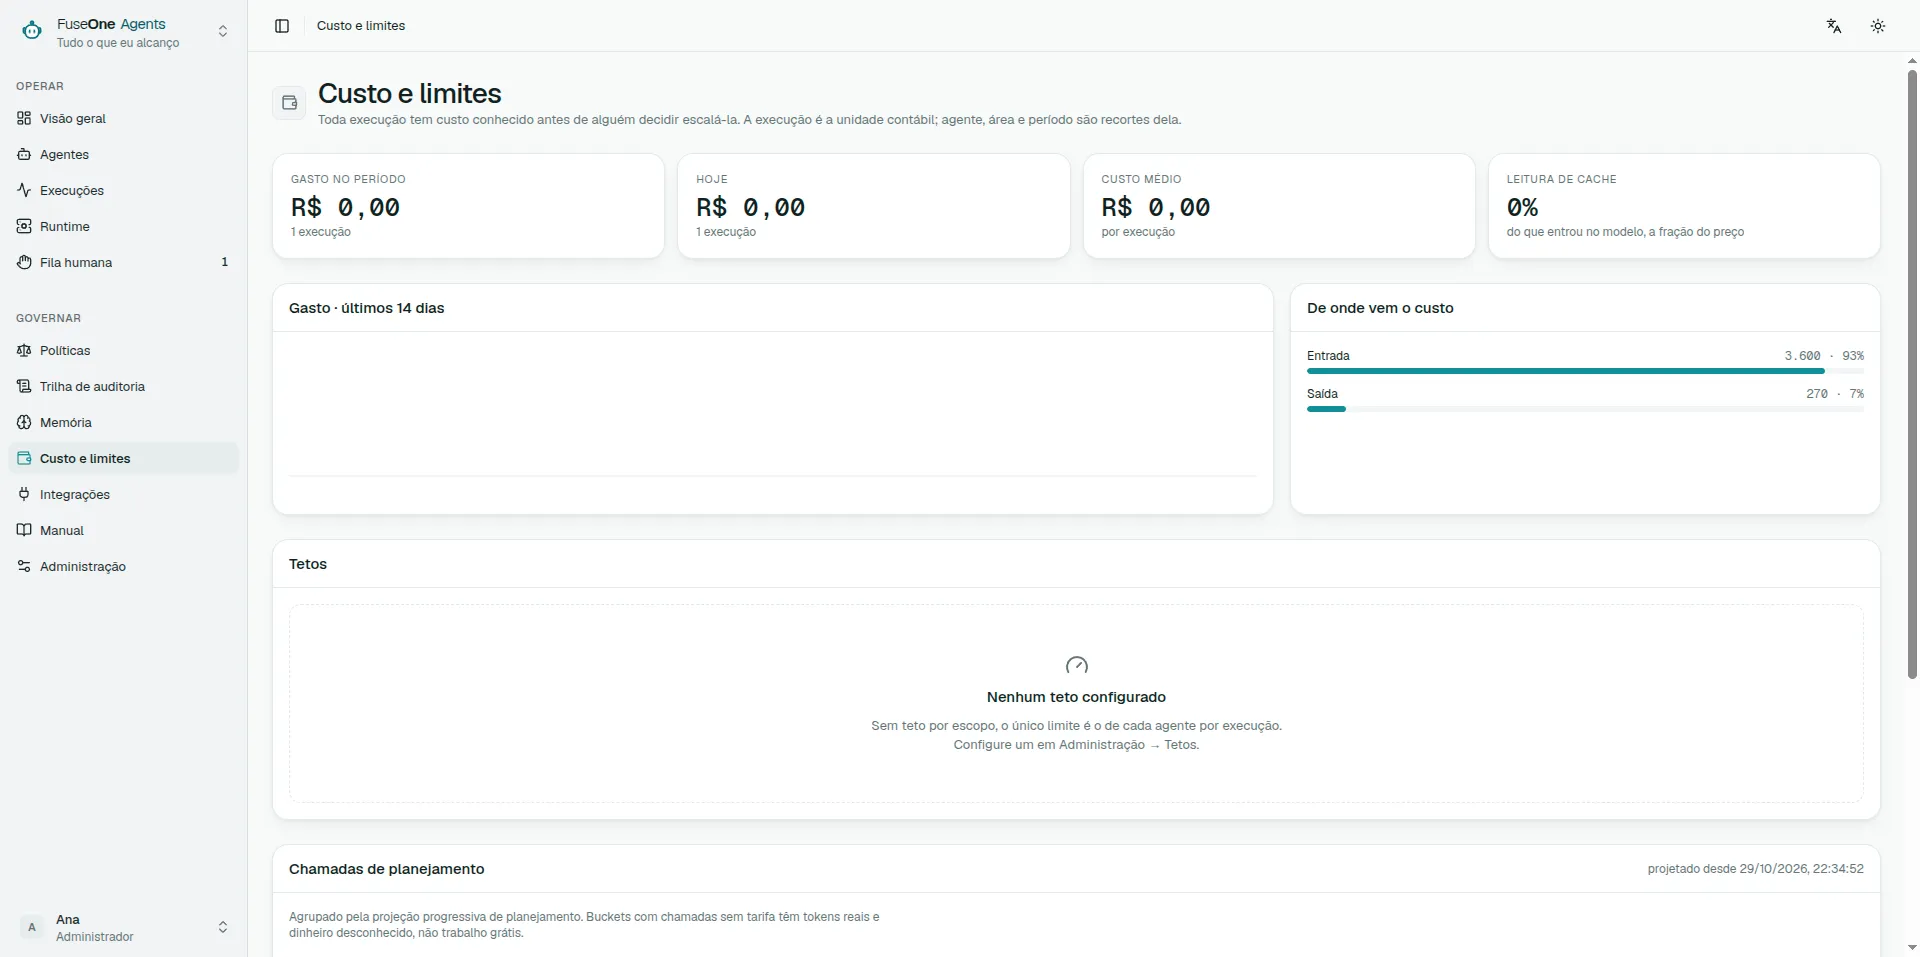
A plataforma conta tokens em cada run. Para transformar tokens em dinheiro, a instalação precisa ter uma tarifa configurada para o par provedor/modelo usado.
Preço de mercado exibido na tela é referência. Ele ajuda o operador a preencher o formulário, mas não conta em tetos até ser salvo como tarifa da instalação. Isso evita somar dólares de mercado dentro de uma instalação configurada em BRL, EUR ou outra moeda.
Por que uma run pode mostrar custo zero
Section titled “Por que uma run pode mostrar custo zero”Uma run com tokens e custo zero quase sempre significa uma destas coisas:
| Sintoma | Leitura |
|---|---|
| Tokens aparecem, custo R$0.00 | Não há tarifa configurada para aquele provedor/modelo |
| Teto bloqueou, mas custo é zero | O teto atingido pode ser de passos, chamadas ou duração, não dinheiro |
| Tarifa foi criada e run antiga segue zero | Histórico não é reprecificado |
| Tarifa foi criada e run nova segue zero | Worker ainda não carregou a revisão, ou provedor/modelo não casam exatamente |
O nome do modelo precisa casar com o que a run usa. claude-opus-5 e
claude-opus-5-20260801 são preços diferentes se o provedor registrar nomes
diferentes.
A moeda da instalação diz como renderizar valores já gravados e tarifas configuradas. Trocar a moeda não converte histórico. Ela muda como os números são lidos.
Não use a troca de moeda como conversão financeira. Se a instalação mudou de BRL para USD, revise tetos e tarifas explicitamente.
Uma run pode parar por quatro famílias de limite:
- dinheiro;
- tokens ou custo estimado;
- número de ferramentas chamadas;
- passos ou duração.
Quando o Gate bloqueia, leia a frase do evento. Ela diz qual teto foi atingido: dinheiro, chamadas, passos ou outro limite. Configurar preço resolve só o teto financeiro; não aumenta limite de passos.
Reserva e reconciliação
Section titled “Reserva e reconciliação”Antes de gastar, a plataforma reserva o custo estimado. Depois da chamada, ela reconcilia com o custo real e libera o que sobrou.
Isso é por tempo, não por contabilidade bonita: se a plataforma só contasse depois, vinte workers poderiam abrir chamadas ao mesmo tempo antes de qualquer um registrar o custo.
Cache reads e cache writes
Section titled “Cache reads e cache writes”Alguns provedores cobram entrada cacheada por preço menor. A tela separa input, output, cache read e cache write porque eles não custam igual.
Mesmo quando cache read é barato, ele ainda é consumo. Otimização boa é aquela que aparece na contabilidade, não a que desaparece dela.
Todo provider de modelo recebe o mesmo transcript limitado, identidade canônica de chamada, orientação de memória consciente do estado e supervisão de falta de progresso. O FuseOne também mantém reutilizáveis as instruções estáveis e o transcript anterior reconstruído da trilha. Todo provider recebe a mesma orientação estável por etapa, as mesmas regras de memória e o teto fixo da run. Anthropic marca esse prefixo com breakpoints explícitos e acrescenta o orçamento restante mutável depois do transcript cacheado. Providers OpenAI-compatible omitem esse saldo por turno porque o cache automático exige um prefixo comum exato; o Gate determinístico continua impondo o mesmo teto. Quando os resultados cruzam o orçamento do transcript, o FuseOne troca uma geração completa por recibos de uma vez. Isso inicia um prefixo limitado novo e o mantém estável até a próxima geração cruzar, em vez de mover a fronteira dos recibos a cada turno. Providers sem cache de prompt ainda economizam chamadas e bytes reenviados. Tokens reportados de cache read e cache write continuam visíveis na execução e nas métricas de baixa cardinalidade do worker.
Leituras concluídas podem consultar novamente os mesmos argumentos porque a fonte pode mudar. Escritas, buscas equivalentes de memória governada e chamadas com desfecho desconhecido depois do reinício de um worker continuam idempotentes. Três leituras bem-sucedidas da mesma ferramenta que devolvem o mesmo digest completo ainda estacionam a run antes de um quarto turno do modelo, mesmo quando os argumentos eram idênticos.
Descobrir o que deixou o prompt grande
Section titled “Descobrir o que deixou o prompt grande”A trilha da run mostra o conteúdo do prompt em cada proposta do modelo: instruções, entrada, notas da plataforma e resultados de ferramenta.
Esses números são bytes de conteúdo, medidos pela plataforma enquanto monta o pedido ao modelo. Eles não são tokens e não são custo. Tokens e dinheiro continuam vindo do uso reportado pelo provedor e da tarifa configurada na instalação.
Use essa linha para escolher a próxima otimização. Se resultados de ferramenta dominarem, reduza ou resuma a saída daquela ferramenta. Se instruções dominarem, reescreva os blocos do agente. Se entrada dominar, envie menos contexto para a run.
Entradas grandes vindas de canal também são compactadas antes de chegar ao modelo. A ask completa continua no content store e na trilha; o modelo recebe um JSON válido com campos longos encurtados e uma nota separada da plataforma com tamanho guardado e digest. Isso aparece principalmente quando um alerta ou thread do Slack traz um payload grande antes de o agente chamar qualquer ferramenta.
Resultados grandes de Grafana Loki e Prometheus, material de revisão do GitHub e resultados de fetch, list e search do Outline são compactados antes dos turnos seguintes do modelo. Tamanho e digest do resultado completo continuam na trilha; o content store mantém sua cópia limitada pelo teto da instalação. O modelo recebe uma visão compacta com começo, fim, tamanho original e digest.
Também existe um orçamento total para resultados no transcript. Evidência recente é preservada; resultados antigos viram recibos explícitos com ferramenta, tamanho do resultado original, digest e bytes omitidos. Recibo nunca significa que o conteúdo não existia e não apaga a cópia armazenada. Ele orienta o modelo a fazer outra chamada somente quando conseguir restringir materialmente a consulta.
Métricas do worker expõem bytes agregados de resultados no prompt como sent
e elided, tokens de cache como read e write, duplicatas canônicas puladas
e investigações estacionadas. Elas deliberadamente não usam execução, agente,
ferramenta, pessoa ou consulta como label; a atribuição por ferramenta fica na
trilha de cada execução.
Checklist de configuração
Section titled “Checklist de configuração”- Configure a moeda da instalação.
- Confira o provedor/modelo que aparece na run.
- Abra Cost and limits e crie uma tarifa para esse par exato.
- Use o preço de mercado como referência, não como valor automático.
- Rode uma run nova.
- Se o custo continuar zero, confira se o worker carregou a revisão e se o nome do modelo bate exatamente.
A janela de cache do prefixo
Section titled “A janela de cache do prefixo”As instruções e os schemas de tools de um agente formam um prefixo estável que o provedor consegue cachear. Por padrão o cache vive cinco minutos: sobra dentro de uma run, acaba antes da próxima run horária — então um agente disparado de hora em hora re-escreve o prefixo inteiro a cada run, e escrita de cache é a classe cara.
A definição do agente pode escolher a janela longa no frontmatter:
cache_prefix_ttl: 1hA janela de uma hora dobra a tarifa de escrita, mas deixa a run seguinte ler o prefixo de volta em vez de re-escrevê-lo; para um agente que roda pelo menos uma vez por hora, a escrita acontece uma vez e o resto do dia é leitura. Só o prefixo estável é afetado — a conversa em si continua na janela curta, porque muda a cada run e cacheá-la por mais tempo é dinheiro em tokens que nunca serão lidos de novo.
Deixe sem valor para agentes disparados sob demanda ou menos que de hora em hora: eles pagariam a escrita dobrada sem nunca colher a leitura. O valor faz parte da definição publicada, então mudá-lo é uma versão nova como qualquer outra edição.
A janela de uma hora tem tarifa própria de escrita na tela de preços — “escrita de cache 1h” — porque o provedor cobra acima da janela curta. Configure-a quando algum agente usar a janela de 1h; vazia, as escritas de 1h cobram na tarifa curta, o que as subestima.